Il 5 novembre 2026, OpenAI ha annunciato il lancio del modello informatico GPT-6, progettato per aiutare i ricercatori di sicurezza a scoprire e indagare sulle vulnerabilità del software e a sviluppare le soluzioni necessarie prima che vengano sfruttate da soggetti malintenzionati.
L'azienda ha classificato le capacità del modello nel campo della sicurezza informatica al livello "Critico". “Critico” secondo il suo quadro di valutazione del rischio, rispetto al livello “Alto” assegnato alla generazione precedente GPT-5.6 Cyber.
Questa valutazione non indica un attacco effettivo o un nuovo hack, ma piuttosto il livello di capacità tecniche dimostrato dal modello in specifici test di sicurezza.
ApriAI+1
Risultati eccezionali in Firefox E Linux
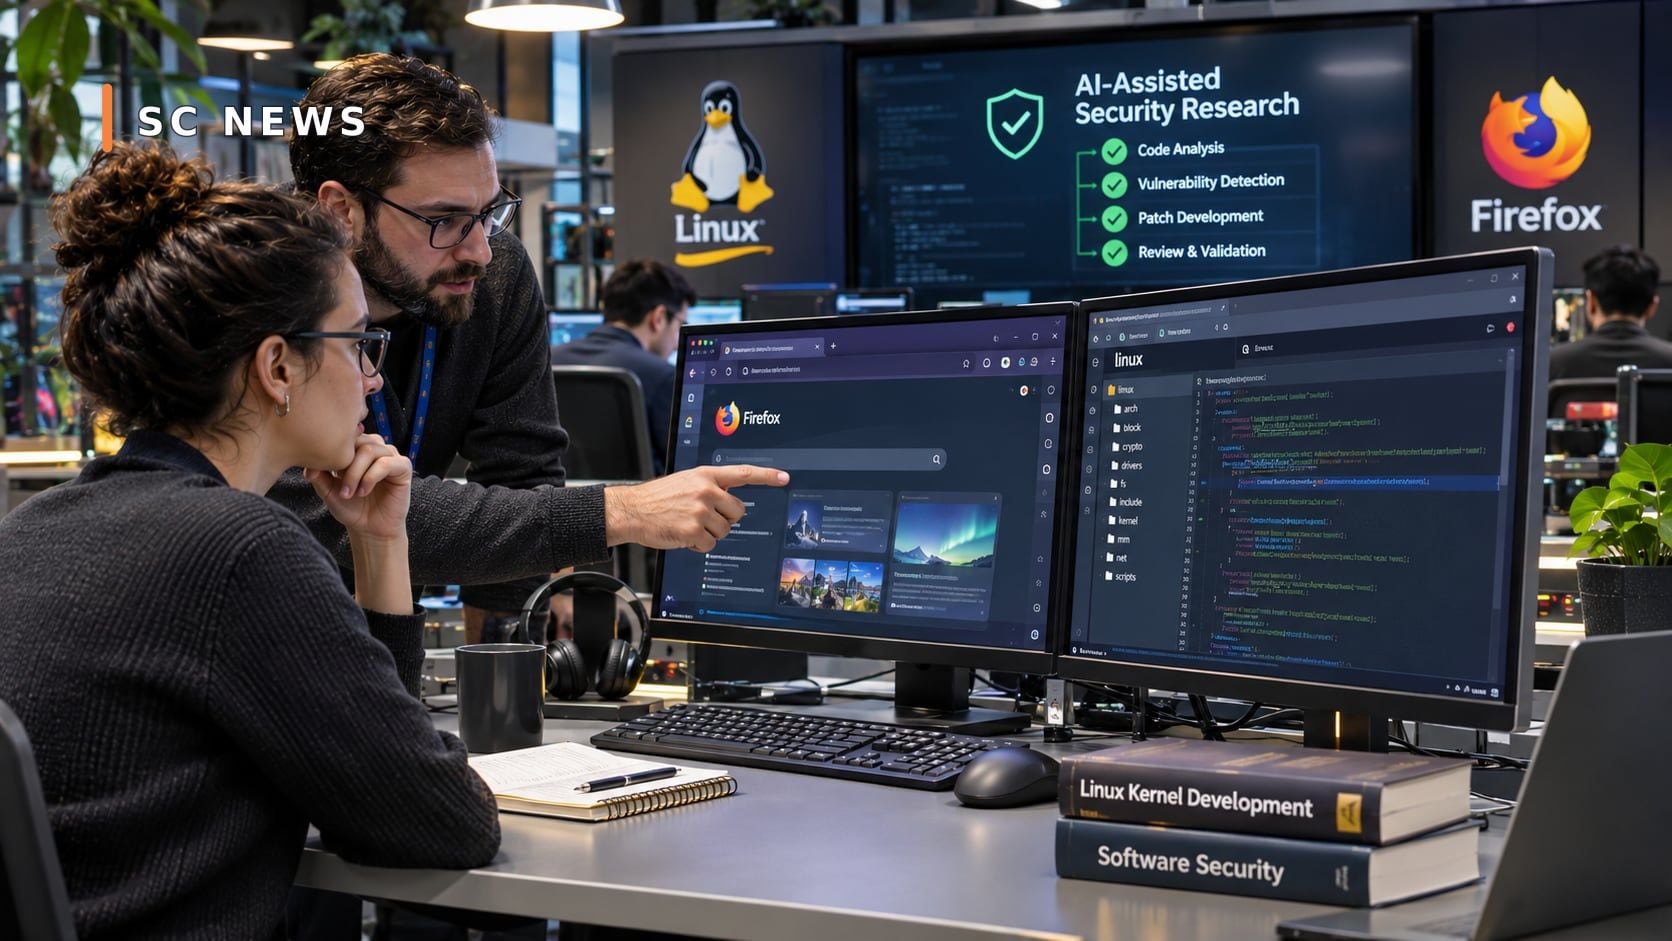
Uno dei risultati più notevoli presentati da OpenAI è stato il contributo del modello alla scoperta di 81 vulnerabilità precedentemente sconosciute nel browser Firefox, che Mozilla ha classificato come ad alto rischio.
L'azienda ha affermato di aver presentato i risultati della ricerca a Mozilla, con proposte di riforma, e che quest'ultima ha iniziato a rilasciare patch per una serie di Problemi scoperti.
In una ricerca separata sul kernel Linux, GPT-6 Cyber ha contribuito a riprodurre 1.724 vulnerabilità e a sviluppare metodi pratici di verifica per sfruttarne 948 all'interno di ambienti di ricerca autorizzati.
L'azienda ha riferito di aver informato gli sviluppatori Linux di 304 risultati critici, accompagnati da suggerimenti per correggere i problemi.
E chi È necessario distinguere tra vulnerabilità che sono state testate per lo sfruttamento in un ambiente di ricerca e vulnerabilità che sono state oggetto di attacchi in sistemi reali. I numeri pubblicati non significano che 948 dispositivi o sistemi siano stati compromessi.
OpenAI
Miglioramento dei test attitudinali
I test OpenAI lo hanno dimostrato Le prestazioni del modello interno sul benchmark ExploitGym sono aumentate al 48,5%, rispetto al 32,1% della generazione precedente GPT-5.6 Cyber.
Questo criterio misura la capacità del modello di affrontare problemi di sicurezza specifici all'interno di ambienti di valutazione controllati e non rappresenta un tasso di successo generale in tutti i tipi di attacchi o test di protezione. realismo.
L'azienda ha inoltre annunciato risultati riguardanti la capacità del modello di aderire all'ambito della missione dichiarata, il che rappresenta un problema critico quando si utilizzano sistemi che operano con un certo grado di autonomia.
Da una valutazione è emerso che nel 99,93% dei casi il modello ha evitato di trattare servizi al di fuori dell'ambito specificato. Dei casi senza ulteriori istruzioni di implementazione, la percentuale ha raggiunto il 100% in condizioni di test con tali istruzioni applicate.
Questi risultati si basano sulla metodologia di valutazione pubblicata e non costituiscono una garanzia che non si verifichino errori in ogni utilizzo futuro.
Perché le nuove funzionalità innescano un dibattito sulla sicurezza?
La sensibilità dei modelli di nicchia della sicurezza informatica risiede nella loro natura a duplice uso.
Un ricercatore di sicurezza può trarre vantaggio da un modello in grado di analizzare codice complesso, scoprire un problema difficile da osservare e dimostrarne la gravità in modo da aiutare gli sviluppatori a risolverlo.
Ma capacità analitiche Il software sviluppato può anche essere utile per le parti che cercano di sfruttare i sistemi senza autorizzazione.
Ecco perché OpenAI sta cercando di combinare il miglioramento delle capacità di ricerca con le restrizioni sull'accesso al modello e il monitoraggio degli usi associati ad attività ad alto rischio.
Accesso tramite Daybreak Red
Lo ha spiegato l'azienda La disponibilità iniziale di GPT-6 Cyber è limitata a un gruppo selezionato di clienti certificati nel programma Daybreak Red, destinati a test di sicurezza avanzati e autorizzati.
Reuters ha affermato che la società intende espandere gradualmente l'accesso ad altre entità approvate nel programma nel corso del tempo Settimane dopo l'annuncio.
I controlli annunciati da OpenAI includono la revisione delle attività ad alto rischio, il monitoraggio del rispetto dell’ambito di lavoro e misure per proteggere le credenziali dei clienti e limitare gli abusi.
Reuters
Cosa significa questo per lo sviluppo del software?
I modelli avanzati potrebbero cambiare Il modo di organizzare le revisioni della sicurezza, soprattutto in progetti software di grandi dimensioni che necessitano di un'analisi continua del codice e del monitoraggio delle correzioni tra le diverse versioni.
Questi strumenti possono aiutare a ridurre il tempo che intercorre tra la scoperta di un problema e la sua presentazione agli sviluppatori in una forma verificabile.
Ma Affidarsi a modelli di intelligenza artificiale non elimina la necessità di revisione umana o di divulgazione coordinata delle vulnerabilità; Risultati imprecisi o la divulgazione anticipata di dettagli sensibili possono causare nuovi problemi di sicurezza.
Qual è il prossimo passo?
Il futuro di GPT-6 Cyber dipende dal successo di OpenAI nell’espandere l’accesso I ricercatori difensivi sono in grado di accedere alle sue capacità, senza trasformare queste capacità in strumenti che possono essere facilmente utilizzati in modo improprio.
I risultati della collaborazione con gli sviluppatori di Firefox e Linux costituiranno anche un indicatore pratico del valore che i modelli specializzati possono aggiungere ai processi di sviluppo software sicuri.