أعلنت OpenAI في 5 نوفمبر 2026 إطلاق نموذج GPT-6 Cyber، المصمم لمساعدة الباحثين الأمنيين على اكتشاف الثغرات البرمجية والتحقق منها وتطوير الإصلاحات اللازمة قبل استغلالها من جهات ضارة.
وصنفت الشركة قدرات النموذج في مجال الأمن السيبراني عند مستوى «Critical» أو «حرج» وفق إطارها لتقييم المخاطر، مقارنة بمستوى «High» الذي منحته للجيل السابق GPT-5.6 Cyber.
ولا يشير هذا التصنيف إلى وقوع هجوم فعلي أو اختراق جديد، بل إلى مستوى القدرات التقنية التي أظهرها النموذج في الاختبارات الأمنية المحددة.
OpenAI+1
نتائج بارزة في Firefox وLinux
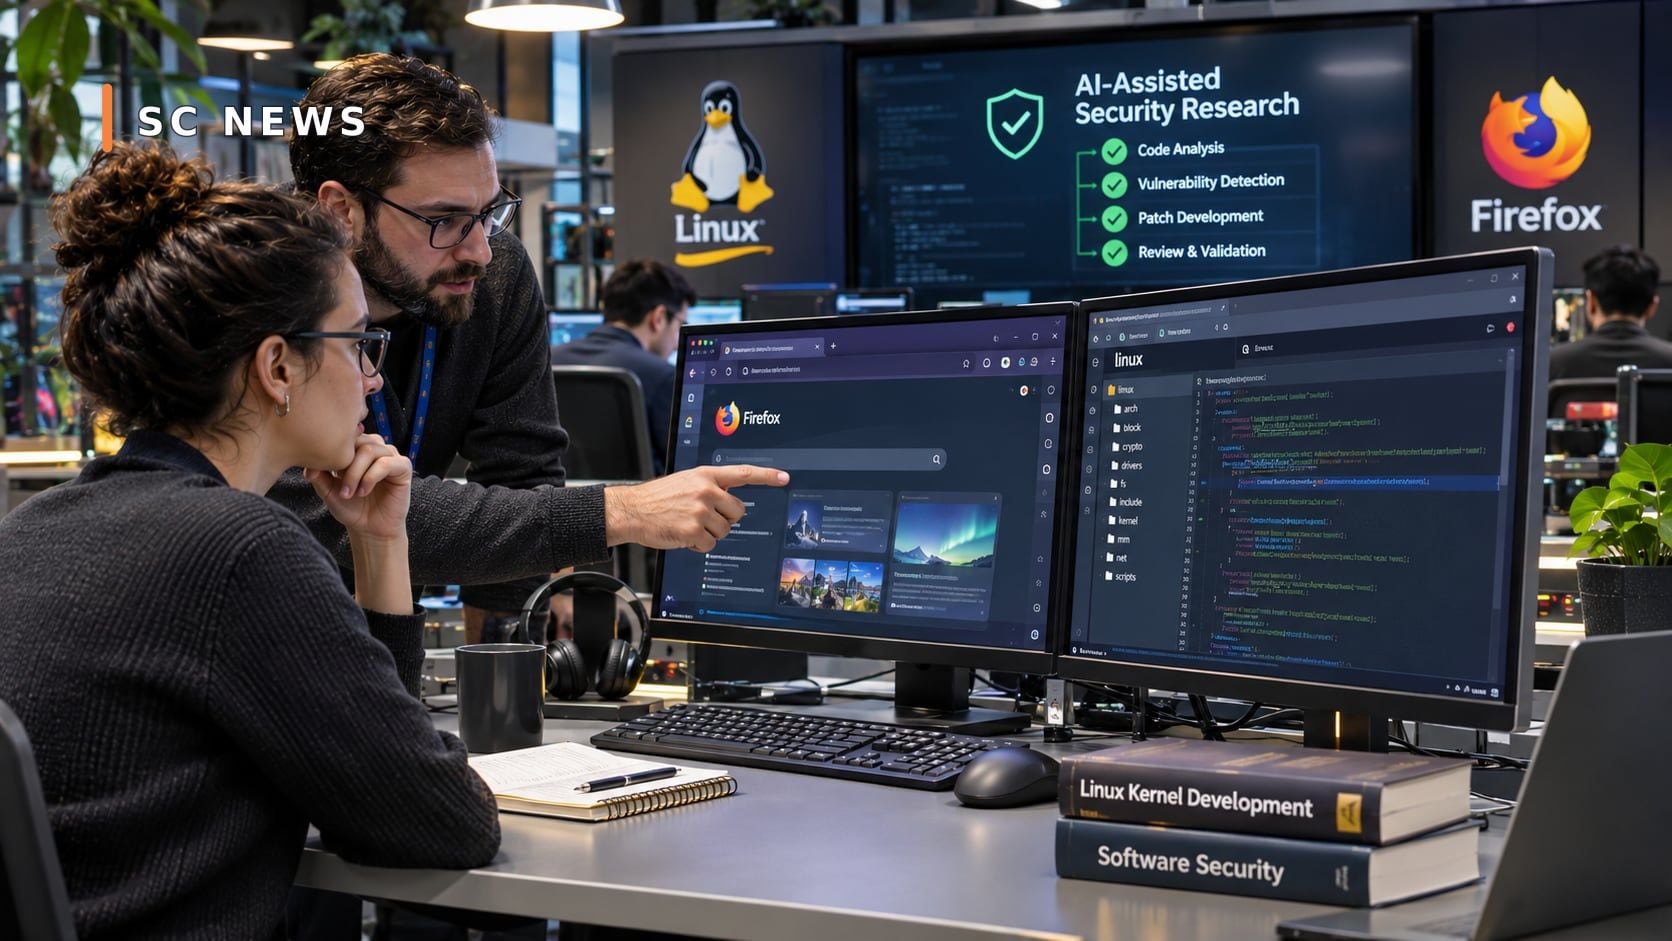
من أبرز النتائج التي عرضتها OpenAI مساهمة النموذج في اكتشاف 81 ثغرة لم تكن معروفة سابقًا في متصفح Firefox، وصنفتها Mozilla على أنها عالية الخطورة.
وقالت الشركة إنها قدمت نتائج الأبحاث إلى Mozilla، مع مقترحات للإصلاح، وإن الأخيرة بدأت إصدار تصحيحات لعدد من المشكلات المكتشفة.
وفي أبحاث منفصلة على نواة Linux، ساعد GPT-6 Cyber في إعادة إنتاج 1724 ثغرة وتطوير وسائل تحقق عملية لاستغلال 948 منها داخل بيئات البحث المصرح بها.
وأفادت الشركة بأنها أبلغت مطوري Linux عن 304 نتائج حرجة، مرفقة بمقترحات لتصحيح المشكلات.
ومن الضروري التمييز هنا بين الثغرات التي أمكن اختبار إمكانية استغلالها داخل بيئة بحثية، وبين الثغرات التي تعرضت لهجمات في أنظمة حقيقية. فالأرقام المنشورة لا تعني تعرض 948 جهازًا أو نظامًا للاختراق.
OpenAI
تحسن في اختبارات القدرات
أظهرت اختبارات OpenAI الداخلية ارتفاع أداء النموذج على معيار ExploitGym إلى 48.5%، مقابل 32.1% للجيل السابق GPT-5.6 Cyber.
وهذا المعيار يقيس قدرة النموذج على التعامل مع مسائل أمنية محددة ضمن بيئات تقييم مضبوطة، ولا يمثل نسبة نجاح عامة في جميع أنواع الهجمات أو اختبارات الحماية الواقعية.
كما أعلنت الشركة نتائج تتعلق بقدرة النموذج على الالتزام بنطاق المهمة المصرح بها، وهي مسألة شديدة الأهمية عند استخدام أنظمة تعمل بدرجة من الاستقلالية.
فقد أظهرت إحدى التقييمات أن النموذج تجنب التعامل مع خدمات خارج النطاق المحدد في 99.93% من الحالات دون تعليمات النشر الإضافية، ووصلت النسبة إلى 100% في ظروف الاختبار مع تطبيق تلك التعليمات.
وتبقى هذه النتائج مرتبطة بمنهجية التقييم المنشورة، وليست ضمانًا بعدم وقوع أخطاء في كل استخدام مستقبلي.
لماذا تثير القدرات الجديدة نقاشًا أمنيًا؟
تكمن حساسية النماذج المتخصصة في الأمن السيبراني في طبيعتها مزدوجة الاستخدام.
فقد يستفيد الباحث الأمني من نموذج قادر على تحليل شيفرة معقدة، واكتشاف مشكلة يصعب ملاحظتها، وإثبات مدى خطورتها بصورة تساعد المطورين على إصلاحها.
لكن القدرات التحليلية المتقدمة قد تكون ذات قيمة أيضًا لجهات تسعى إلى استغلال أنظمة دون تصريح.
ولهذا تحاول OpenAI الجمع بين تحسين القدرات البحثية وفرض قيود على الوصول إلى النموذج ومراقبة الاستخدامات المرتبطة بالأنشطة عالية الخطورة.
الوصول عبر Daybreak Red
أوضحت الشركة أن الإتاحة الأولية لـGPT-6 Cyber تقتصر على مجموعة مختارة من العملاء المعتمدين في برنامج Daybreak Red، المخصص لأعمال الاختبار الأمني المتقدمة والمصرح بها.
وقالت وكالة Reuters إن الشركة تعتزم توسيع الوصول تدريجيًا إلى الجهات الأخرى المعتمدة في البرنامج خلال الأسابيع التالية للإعلان.
وتشمل الضوابط التي أعلنتها OpenAI مراجعة الأنشطة عالية الخطورة، ومراقبة الالتزام بنطاق العمل، وإجراءات لحماية بيانات اعتماد العملاء والحد من إساءة الاستخدام.
Reuters
ماذا يعني ذلك لتطوير البرمجيات؟
قد تغير النماذج المتقدمة طريقة تنظيم مراجعات الأمان، خاصة في المشروعات البرمجية الكبيرة التي تحتاج إلى تحليل مستمر للشيفرة وتتبع الإصلاحات بين الإصدارات المختلفة.
ويمكن أن تساعد هذه الأدوات على تقليل الوقت بين اكتشاف المشكلة وتقديمها للمطورين بصورة قابلة للتحقق.
لكن الاعتماد على نماذج الذكاء الاصطناعي لا يلغي الحاجة إلى المراجعة البشرية أو الإفصاح المنسق عن الثغرات؛ إذ إن النتائج غير الدقيقة أو الكشف المبكر عن تفاصيل حساسة قد يسببان مشكلات أمنية جديدة.
ماذا بعد؟
يرتبط مستقبل GPT-6 Cyber بمدى نجاح OpenAI في توسيع وصول الباحثين الدفاعيين إلى قدراته، دون تحويل هذه القدرات إلى أدوات يسهل إساءة استخدامها.
كما ستكون نتائج التعاون مع مطوري Firefox وLinux مؤشرًا عمليًا على القيمة التي يمكن أن تضيفها النماذج المتخصصة إلى عمليات تطوير البرمجيات الآمنة.